この記事は2026年10月時点の情報をもとにしています。
チャットの会話だけで商品購入を完結させる対話型コマースが注目を集めています。しかし従来の単一AIボットでは、接続遮断や計算ミス、API費用が課題でした。
こうした課題に対し、Google公式開発者ブログが自律型基盤「HappyDelivery」のプロトタイプを公開しました。LangGraphとGeminiの3層分離設計を採用しています。1注文あたりの推論費用を約0.0061ドル(約0.9円)に抑え、堅牢に注文を処理します。
この記事でわかること:
- Google公式が公開した対話コマース基盤「HappyDelivery」の3層設計
- LangGraphとGeminiを連携させたマルチエージェント協調の仕組み
- 1注文あたり約0.0061ドルに抑えるトークン経済性とキャッシュ活用法
この記事が向いている読者:
- WhatsAppやSMS、チャット経由の自動販売を検討している事業責任者
- LangGraphを用いた状態保持型マルチエージェントを構築したい開発者
- LLMによる金額計算の誤りやWebhook遮断に悩んでいるエンジニア
Google公式が明かした対話型コマースの自律プロトタイプ
2026年10月27日、Google Developers Blogで新技術が公開されました。自律型対話コマース基盤「HappyDelivery」の実動プロトタイプです。執筆者はGoogleのPrateek Khushalani氏です。
この基盤は、チャット上での顧客との自然な対話を通じて注文を完結させます。公開されたアーキテクチャの概要は以下の3点です。
- オムニチャネルの受信を150ms未満で即時応答し、再送による二重注文を排除する設計
- インメモリDB(Redis)を用い、0.318msの低遅延でカート状態と顧客好みを復元する仕組み
- GeminiとLangGraphを組み合わせ、四則演算をPython関数に委譲して計算誤差をゼロにする構成
技術の詳細はGoogle Developers Blogの公式発表で詳しく解説されています。単一プロンプトへの依存から脱却し、各工程の責務を分離した点が特徴です。
何が変わるか:対話型AIコマースの実用化で変わる買い物体験と業務
対話型AIコマースの進化により、顧客の購入体験と事業者のシステム運用の両面が刷新されます。画面を行き来して検索や決済入力を繰り返す手間はかかりません。
顧客は日常のメッセージアプリ上で話しかけるだけで買い物を進められます。例えば「いつもの炭酸水と辛口カレーのスパイスを追加して」と入力するだけです。過去の購入履歴が保持されるため、細かな指定なしで希望通りのカートが完成する設計です。
事業者にとっては、チャットコマース運用の最大の障壁であった通信切断を防止できます。Webhook(外部アプリの更新を即時通知する仕組み)の遅延に伴う再送障害の発生も防ぐ構成です。
さらに高額になりがちな推論費用が極小化されるため、利益率を圧迫しません。少人数の開発運用体制でも、24時間稼働する堅牢な販売窓口を運用できます。
主な内容:3層分離設計とGemini・LangGraphの連携アーキテクチャ
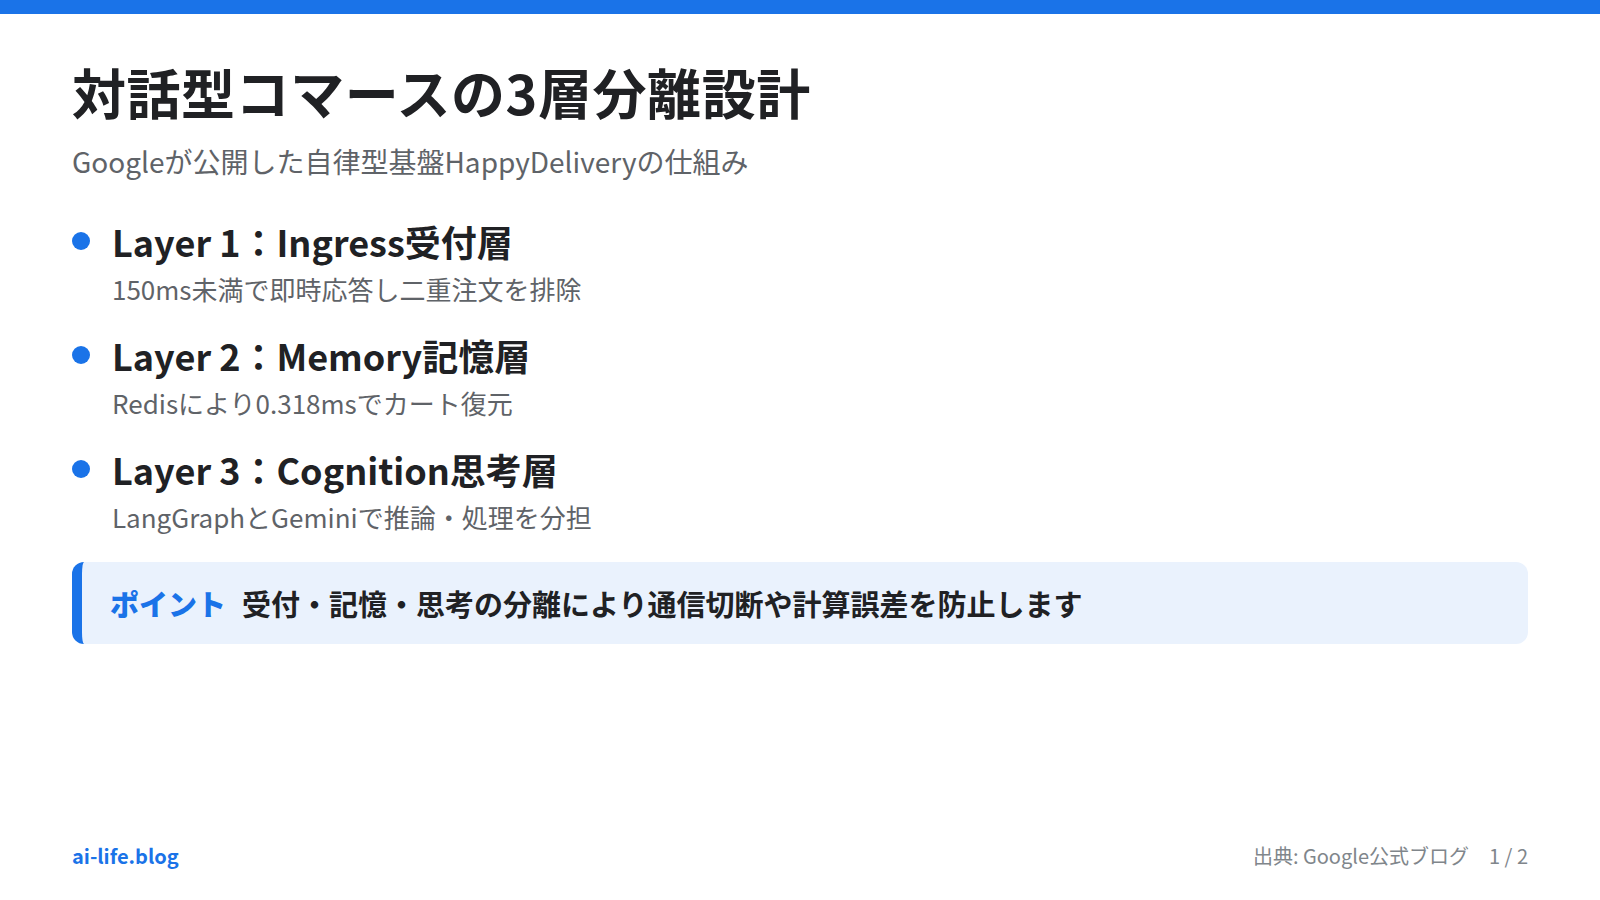
HappyDeliveryの中核は、受付・記憶・思考を切り離した3層分離設計にあります。各層の役割と仕様を以下の表にまとめました。
| 設計レイヤー | 採用技術 | 役割と主要な仕様 |
|---|---|---|
| Layer 1:Ingress(受付層) | FastAPI、Cloud Pub/Sub | 各チャネルの入力を共通形式CommonMessageEventに正規化。150ms未満でHTTP 200を返し再送を遮断。 |
| Layer 2:Memory(記憶層) | Cloud Memorystore for Redis | 電話番号キーsession:{phone_number}でカートを保持。検索時間0.318ms、100万件超のアクティブカートを管理。 |
| Layer 3:Cognition(思考層) | LangGraph、Gemini Flash、Gemini Pro | Supervisorと3つの専門エージェントで分担。モデル階層化と専用ツール呼び出しで推論と処理を実行。 |
Layer 1(Ingress)では、着信イベントを即座にメッセージキューのCloud Pub/Subへ渡します。外部プラットフォームへ150ms未満で応答を返す仕組みにより、多重決済を未然に防ぐ仕様です。
Layer 2(Memory)では、Redis上にセッション情報を保存します。Googleの公式データによると検索時間はわずか0.318msであり、数時間の中断後でも即座にカート状態が復元されます。
Layer 3(Cognition)では、複雑な対話フローを制御するLangGraph公式フレームワークを採用しました。司令塔(Supervisor)には高速なGemini Flashを配置し、遅延を240msに抑える構成です。
各専門業務にはGemini Proを割り当てています。「Profile」「Inventory」「Transaction」の3エージェントに分離しました。このプロンプト分割はGemini APIプロンプト設計ガイドに準拠した堅牢な設計です。(関連記事:GeminiのSkillsとGemsの違い|提供日程と変更点)
トークン経済性:1注文わずか0.0061ドルに抑えるコスト構造と計算精度
AIエージェントの現場導入において、API費用と計算精度は成否を分ける重要要素です。Googleが公開した実証データでは、これらの懸念を払拭する具体的な数値が示されています。(関連記事:LLMのAPI費用を抑える3手法|Claude・OpenAI公式)
実動プロトタイプによる3ターンの購入処理(補充→変更→決済完了)の結果は以下の通りです。
- 総消費トークン数:注文完了までの3ターン合計で約4,240トークン
- 総推論コスト:1注文あたり0.0061ドル(日本円で約0.9円)
- 注文金額に対する費用比率:20.32ドルの注文に対してわずか0.030%
- キャッシュ適用時の削減効果:コンテキストキャッシュの利用により約0.0033ドルまで削減
- 自動テスト結果:5項目(署名検証・カタログ検索・価格計算・3ターン購入・決済)が0.158秒で完了し合格率100%
特筆すべきは、金額計算におけるハルシネーションの防止策です。合計金額や税率(8.25%)、送料(15ドル超で無料、以下3.99ドル)の計算をモデル自身に行わせることはありません。
Gemini APIファンクションコーリング機能を活用しています。計算処理をPython関数calculate_cart_totalsに完全に委譲しました。モデルは数値の抽出のみを担当し、計算はプログラムコードで処理するため誤差が生じません。
さらに固定の商品カタログにはGemini APIコンテキストキャッシング機能を適用する設計です。Gemini 4 ArgonやGemini 3.8 Flashは4,096トークン以上でキャッシュが機能します。これにより入力トークン費用を最大75%削減できます。(関連記事:Gemini 4 Argonの料金と機能|Copilot対応解説)
提供状況と導入に向けた注意点
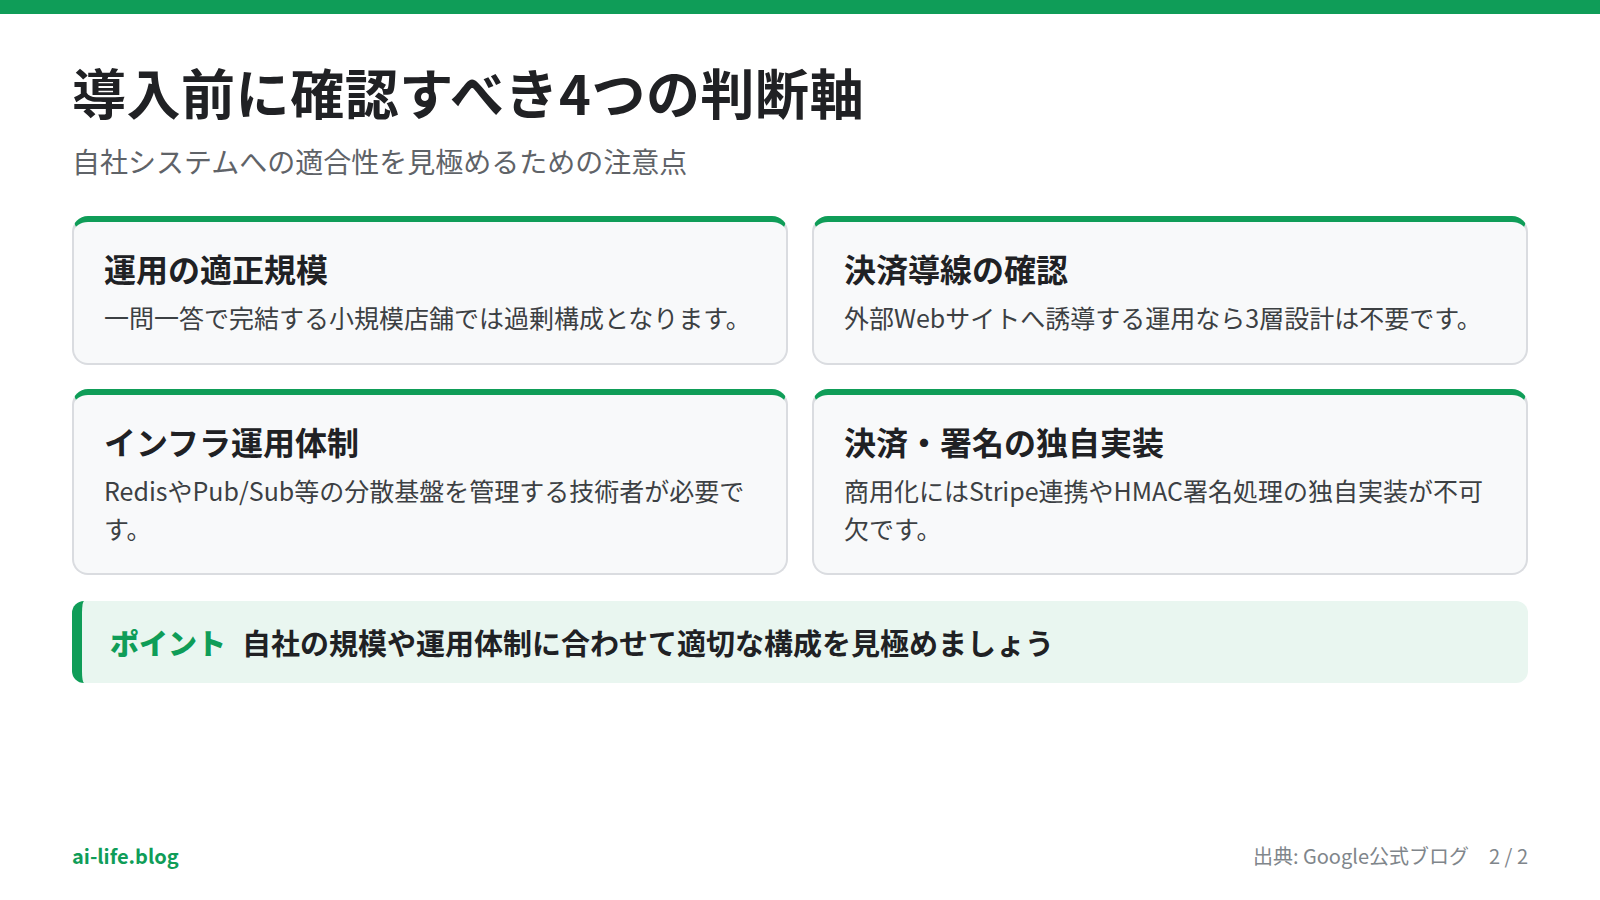
HappyDeliveryはオープンソースの実動プロトタイプです。2026年10月現在、Google公式ブログ等で公開されています。自社システムへ組み込む際は、以下の要件と制約に注意が必要です。
まず、外部決済基盤(Stripeなど)やメッセージ署名検証(HMAC)の独自実装が求められます。プロトタイプには基本的な実装例が含まれますが、商用運用には自社のセキュリティ規程に沿ったトークン管理が不可欠です。
また、すべてのコマース業務にこの3層構成が適しているわけではありません。以下のようなケースでは過剰なシステム構成となる恐れがあります。
- 商品点数がごく少数で、一問一答のFAQボットで完結する店舗
- チャット内で決済せず、自社Webサイトの購入画面へ誘導するだけの運用
- RedisやPub/Subなどの分散クラウド基盤を運用管理できる技術者がいない組織
特にRedis(Cloud Memorystore)の容量計画は極めて重要です。標準インスタンスで100万件超のカートを保持可能です。ただし保持期間(TTL)やアクセス集中時の負荷を考慮した設計が欠かせません。
編集部の見解
HappyDeliveryは、対話型コマースを商用環境で破綻なく動かすための手堅い解法を示しています。Webhookの即時応答、Redisによる状態復元、計算ツールの分離が特徴です。これら3つの要素は実用的なAIエージェント開発の標準パターンとなります。
1注文あたり約0.9円という経済性は、薄利多売の物販やデリバリーでも導入できる水準です。一方で、クラウドインフラの保守運用スキルが必要となるため、社内に専任エンジニアがいない中小事業者には導入のハードルが残ります。
よくある質問(FAQ)
Q: 既存の自社ECシステムや在庫管理データベースと連携できますか?
A: 連携できます。Layer 3のInventoryエージェントに自社APIをツールとして登録することで、既存の在庫DBとリアルタイムに同期する仕組みです。
Q: LLMが金額の計算ミスや勝手な値引きを起こす心配はありませんか?
A: 心配ありません。金額や税率の計算はLLMから完全に切り離されています。決定論的なPython関数(calculate_cart_totals)側で厳密に計算するためです。
Q: どのようなメッセージングサービスで利用できますか?
A: WhatsApp、Google RCS、Apple Messages、SMSなどに対応しています。Layer 1が共通形式CommonMessageEventへ正規化するため、単一の対話ロジックで複数チャネルを制御する設計です。
Q: トークン推論費用以外にどのようなクラウド費用が発生しますか?
A: 主に3つのインフラ費用が発生します。Webhook受信コンテナ(Cloud Run等)、非同期キュー(Cloud Pub/Sub)、およびRedisの利用料です。これらは利用リソース量に応じた従量課金となるため、運用規模に応じた事前試算が求められます。
まとめ
Google公式が発表した対話型コマースの自律プロトタイプ「HappyDelivery」の要点は以下の3点です。
- Ingress・Memory・Cognitionの3層分離により、通信タイムアウトと二重注文を防止
- LangGraphマルチエージェントと計算用関数の分離により、計算エラーをゼロ化
- 1注文あたり0.0061ドルという低廉な推論コストを実現し、実用性を証明
対話型コマースの導入を検討する担当者は、まずGoogle公式の設計資料を確認しましょう。自社のシステム要件に適合するか技術的な検討を進めることが次の第一歩です。
コメント