この記事は2026年11月時点の情報をもとに構成しています。
自律型AIエージェントの業務導入が進む一方、推論コストの高騰が深刻な課題です。AIが思考を深めるほど、APIの利用料金は急激に膨らみます。
Google Cloud AIはこの課題に対し、タスク完了あたりの総コストを最小化する実践的な設計指針を発表しました。高価な推論モデルの常時起動を抑え、安価な判別モデルを前段に組み合わせるアプローチです。
- 高価な推論モデルの呼び出しを抑えるGoogleの費用削減アーキテクチャ
- 判別モデル(JevやDiffusionGemma)とGeminiの具体的な役割分担と仕様比較
- GeminiのThinkingレベル調整とコンテキストキャッシュを両立させる運用ルール
- Gemini APIやAIエージェントの運用コストを抑えたいエンジニアや開発リーダー
- 業務フロー自動化を推進しているが推論費用の増加に直面しているDX担当者
- 判別モデルと生成モデルを組み合わせた最新アーキテクチャの実装手順を知りたい方
Googleが発表したGeminiエージェントの費用削減設計
推論コストの抑制には、安価な判別モデルによる入力の事前ルーティングが最も有効です。
2026年11月3日、Google Cloud AIのSergio Villani氏により、推論コストを最小化する設計指針が公開されました。詳細はGoogle Developers Blogの公式解説記事に記されています。
従来の開発では、入力の仕分けから計画立案まで単一の大型生成モデルに任せる傾向がありました。この構成では、判断を繰り返すたびに大量のトークンが消費されます。
Googleのアプローチは、1フォワードパス(単一計算)で判定を終える安価な判別モデルを前段に置く設計です。入力が定型処理で済むか、深い推論を要するかを高速判定します。
定型タスクは軽量な処理系に流し、計算力が必要な場面のみGeminiを呼び出します。これにより、解決精度を維持したまま運用費用を圧縮する仕組みです。(関連記事:LLMのAPI費用を抑える3手法|Claude・OpenAI公式)
あわせて示されたのが、正規表現やトークン長による静的ルールの限界でした。開発用16問では93.8%の精度を示したものの、未知の34問では70.6%へと急落しています。
23.2ポイントの性能低下は、多様な実務入力に静的ルールが対応できない現実を示しています。Googleはこの結果から、分岐判定にも軽量な判別モデルを採用することが不可欠であると結論付けました。
タスク単価の最適化で何が変わるか・誰に関係あるか
エージェント運用の採算性は、単なるトークン単価ではなくタスク完了あたりの総コストで決まります。
今回の発表で強調されたのは、評価指標の転換でした。これまで注目された指標は「100万トークンあたりの価格」というインフラ単価です。
Google Cloud AIは、真に追跡すべき指標として「成功タスクあたりの総コスト」を定義しました。トークン単価が安くても、判断ミスで試行錯誤を繰り返せば総額は跳ね上がります。
タスク成功率を保ちながら、業務完了までに消費された全ステップの合計金額を下げる工夫が不可欠です。安価な判別モデルで無駄なステップを省く設計は、タスク単価を直接的に引き下げます。
この変化は、AIによる業務自動化を推進するエンジニアや開発責任者に直結する課題です。特に、以下のユースケースを抱える組織に深く関係します。
- Issueを読み取って自動でコード修正とテストを行う自律型コーディングエージェント
- 顧客からの問い合わせをリアルタイムで分類し、担当部署へ振り分けるサポート窓口
- 社内文書やデータベースを横断検索して業務レポートを作成する社内アシスタント
単発プロンプトのチャット利用であれば、モデル呼び出しは1回で済みます。従来のトークン単価の比較だけでコストを管理できる構造です。
一方、自律型エージェントは計画・実行・評価のループを何十回も連続実行します。1ステップあたりの単価を削る工夫が、月末の請求額を抑える決定打となる設計です。(関連記事:GeminiとLangGraphの対話型コマース|3層設計と費用)
判別モデルとGeminiを組み合わせるハイブリッド連携の仕組み
高速な判別モデルで定型判定を捌き、高度な推論のみGeminiへ委譲する分担が不可欠です。
アーキテクチャの核となるのが、判別モデルと生成モデルの役割分担です。これは認知心理学における「システム1(直感・反射)」と「システム2(熟考・論理)」の関係に相当します。
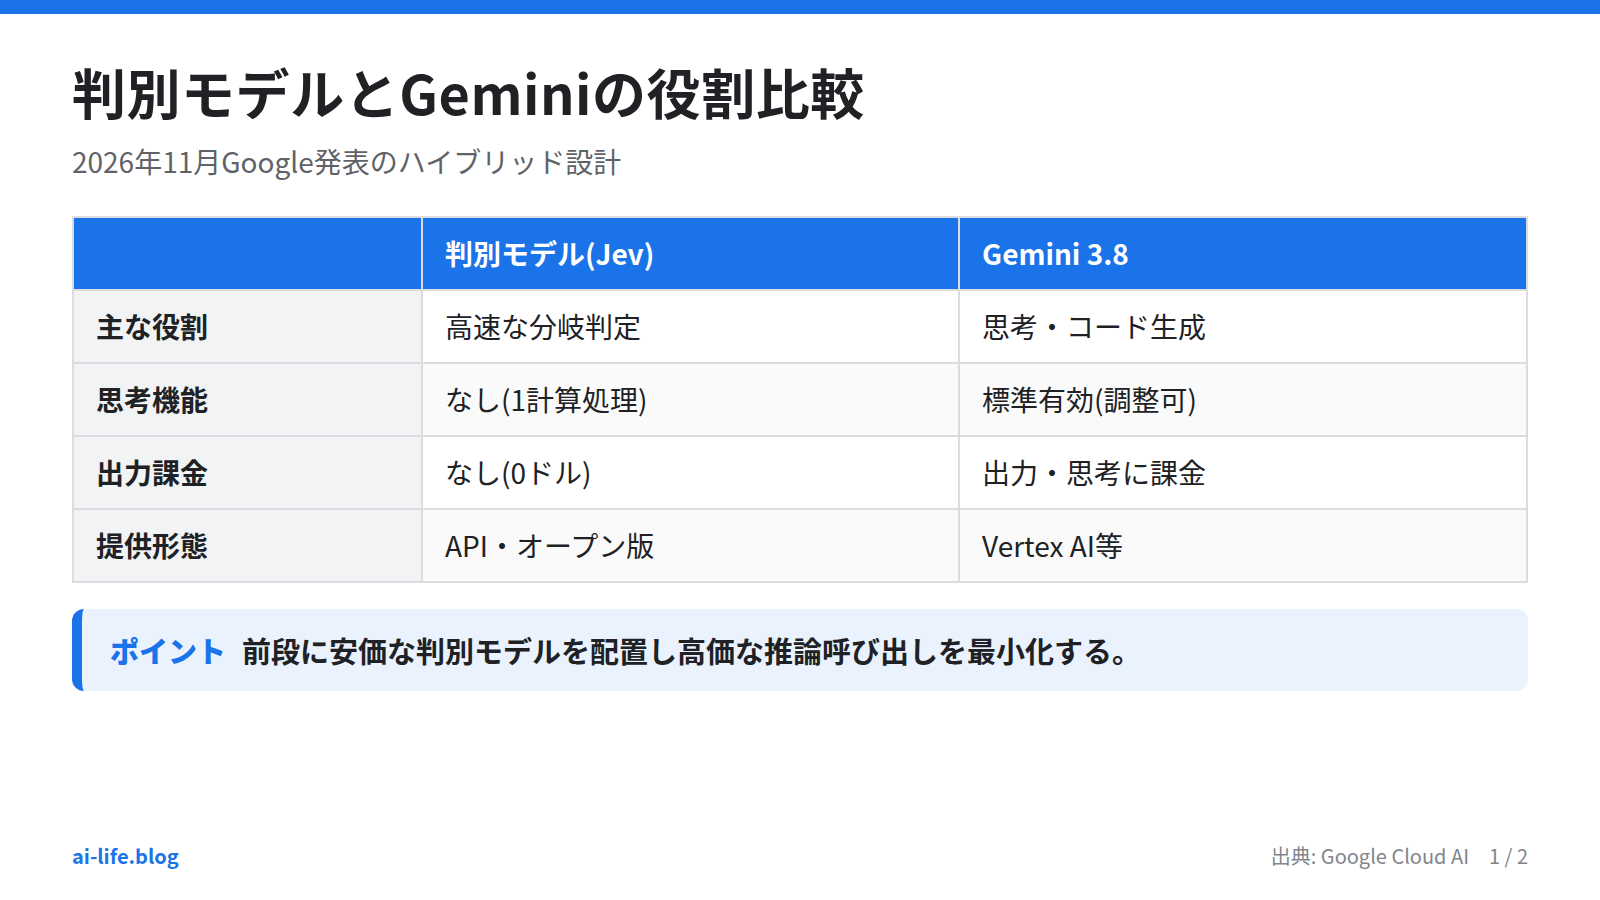
反射的判定を担う代表例が、TypeSafe AIの「jev-latest」やGoogle DeepMindの「DiffusionGemma」です。入力に対し、70msから500msの短時間で型安全な判定値を返します。
分岐精度を高めるため、単一の二値確率判定「Noul(ヌール)」形式が採用されました。曖昧な多肢選択を避け、「複数ステップの計算や論理推論が必要か」を0から1の確率値で判定します。この値がしきい値を超えた場合のみ、高推論なGeminiを起動する設計です。
判別モデルと生成モデルの主な仕様と特徴の違いは以下のとおりです。
| 比較項目 | 判別モデル(jev-latest) | 軽量生成モデル(Gemini 3.8 Flash) | 高推論生成モデル(Gemini 4 Argon / 3.1 Pro) |
|---|---|---|---|
| モデルの役割 | 高速なルーティング判定・二値分類 | 思考を伴う軽量コード生成・要約 | 複雑なマルチステップ推論・設計 |
| 主な出力形式 | Noul(0〜1確率)、Choice、Score | 自然言語テキスト、構造化JSON | 自然言語テキスト、高度なコード出力 |
| 思考機能(Thinking) | 非搭載(1フォワードパスで判定) | 標準有効(LOWへの抑制指定に対応) | 標準有効(深いマルチステップ推論) |
| 出力課金の有無 | 出力トークン課金なし(0ドル) | 出力トークン+思考トークン課金 | 出力トークン+思考トークン課金 |
| 提供形態 | マネージドAPI(オープンモデル版あり) | Google AI Studio / Vertex AI | Google AI Studio / Vertex AI |
TypeSafe AIのjev-latestは、出力トークンへの課金が0ドル、入力100万トークンあたり0.042ドルと極めて安価です。レイテンシも70msから500msと高速に動作します。
定型タスクを前段の判別モデルで処理し、深い思考が必要な難問のみGeminiへ送ることで、無駄な推論コストを遮断できます。
公式ワークショップに基づく導入手順と提供状況
公式CodelabとGitHubリポジトリを活用すれば、ハイブリッド構成を段階的に導入できます。
ハイブリッド設計は概念実証にとどまらず、開発者がすぐに導入手順を学べる教材が整備されました。公式教材としてGoogle Codelabs公式ガイドが提供されています。
また、Google Cloud Americasが管理する公式GitHubリポジトリも利用可能です。コードの全体像はGitHub: gca-americas/discriminative-models-workshopから確認できます。
2026年11月現在、TypeSafe AIの「jev-1.13(jev-latest)」はクラウドAPIとして安定提供中です。Google DeepMindの「DiffusionGemma」はオープンウェイトモデルとして公開されています。Compute EngineのGPU VM(L4等)やCloud Runでのセルフホスト運用に対応する形態です。
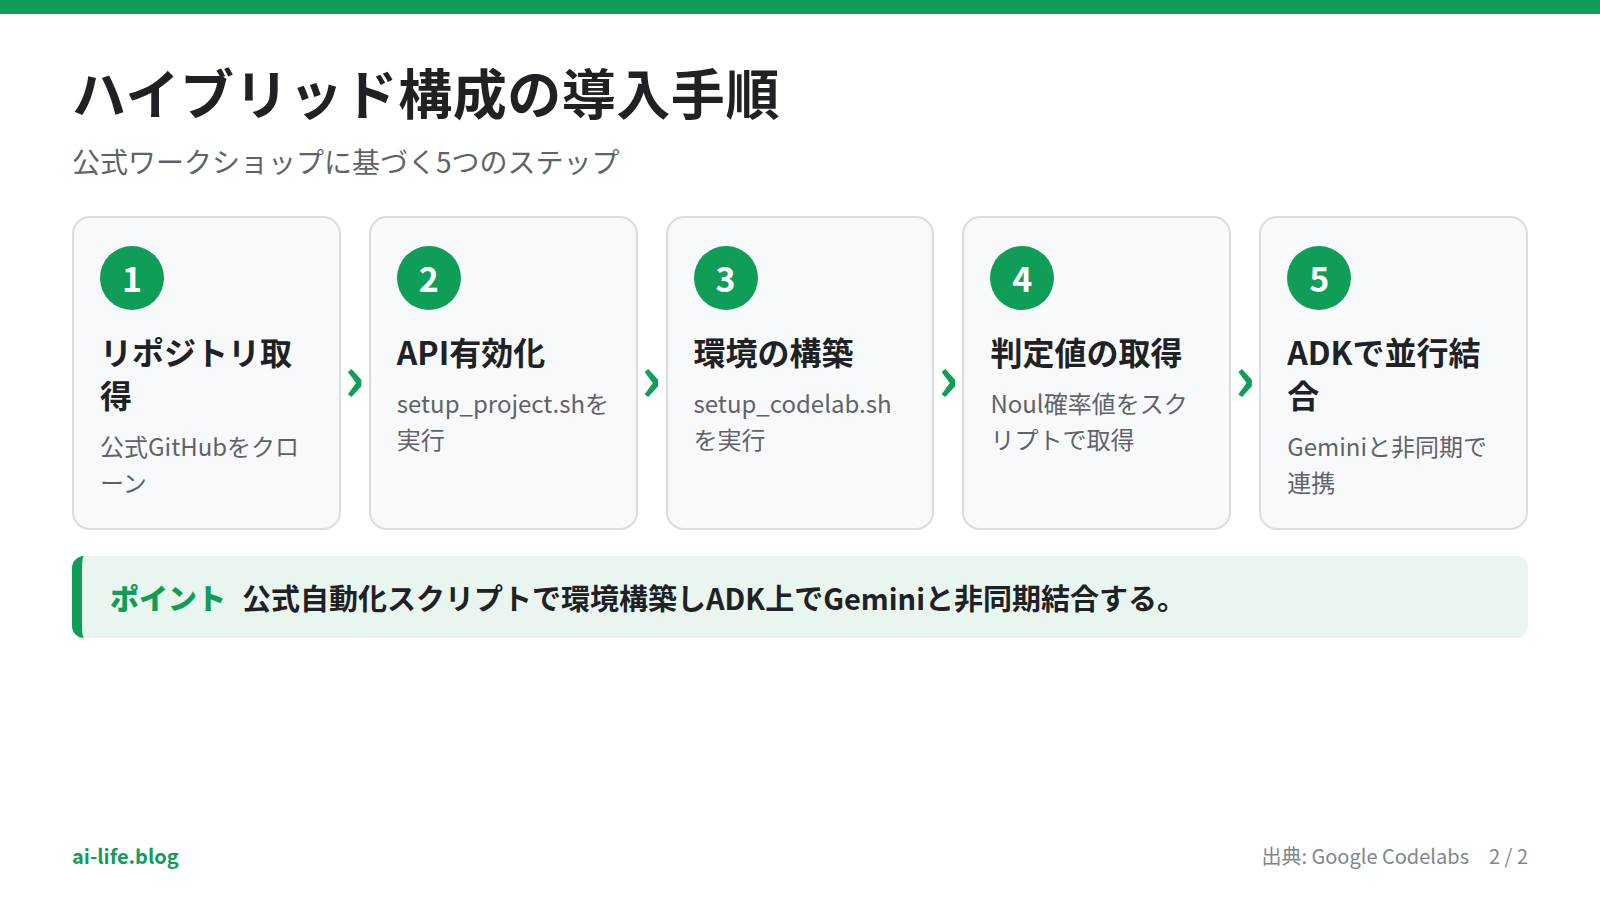
公式教材をもとに環境を構築する手順は以下の5ステップです。
- 公式リポジトリをローカル環境またはGoogle Cloud Shellにクローンします。
- リポジトリの
setup_project.shを実行し、Vertex AIやCompute EngineのAPIを有効化。 - 続いて
setup_codelab.shを実行して必要なPythonパッケージを導入し、ポート4900でワークベンチを起動します。 - 同梱された
first_call.pyやask.pyを実行し、TypeSafeClientを用いて判別モデルからNoul確率値を取得。 - Google ADK(Agent Development Kit)上で、判別モデルの高速ループとGeminiの推論処理を非同期並行で結合します。
自動化スクリプトの活用により、環境構築の手間をかけずに実装へ移行できる環境です。型付きの判定結果を直接受け取れるため、条件分岐も簡潔に記述可能です。
Thinkingレベルとキャッシュ活用における注意点
Thinkingレベルの抑制とコンテキストキャッシュの維持が、Gemini側の費用を最小化する鍵です。
ハイブリッド構成の導入にあたっては、Geminiの推論仕様とキャッシュの仕組みを把握しておく必要があります。設定を誤ると削減効果が薄れます。
第一の注意点は、Gemini APIのThinking(思考)機能のコスト構造です。仕様の詳細はGoogle AI Studio Thinking機能解説に記載されています。
Gemini 4 ArgonやGemini 3.8 Flashはデフォルトで思考が有効(medium)です。思考が有効なリクエストでは、回答文だけでなく推論に消費された全思考トークンが出力トークン単価で課金されます。
Googleが公開した評価データでは、Gemini 3.8 Flashの思考レベルを thinkingLevel: "LOW" に設定した構成が注目されました。ベンチマーク50問すべてを解決しつつ、大幅な低コストを記録しています。安易に思考レベルを高く固定せず、最小限に抑える設計が鉄則です。(関連記事:Gemini 4 Argonの料金と機能|Copilot対応解説)
第二の注意点は、コンテキストキャッシュ(Context Caching)と動的ルーティングの相性です。仕様詳細はGoogle AI Studio Context Caching解説で確認できます。
Gemini APIでは暗黙的キャッシュが標準適用されます。Gemini 4 ArgonやGemini 3.8 Flashでは、4,096トークン以上の共通プロンプトに対して75%から90%の割引が有効です。Gemini 4のエージェントループでは、新規追加が2,050トークン以上で直前リクエスト全体がキャッシュ対象となります。
しかしキャッシュ領域はモデルごとに独立して管理される仕様です。動的ルーティングを細かく行いすぎると、Gemini側のキャッシュが途切れ、割引を逃すリスクが生じる点に留意してください。
実務に組み込む際は、以下の注意点を意識する必要があります。
- 短く自己完結したタスクの選別のみに判別モデルを用い、長大な文脈を保持する対話ターンは同一モデルに固定する
- DiffusionGemmaを自前運用する場合、GPUインスタンス(L4など)の稼働費と保守工数が別途発生する
- 二値判定(Noul)のプロンプト設計が甘いと判定ミスが起きるため、事前のしきい値調整が欠かせない
- 単純な単発問い合わせ業務に導入すると、ルーティング設計の開発工数が見合わなくなる
キャッシュ割引を活かすべき場面と、呼び出し自体を止めるべき場面を適切に切り分ける運用が求められます。
編集部の見解
本アーキテクチャは、多段階処理を繰り返すエージェントにおいて高い費用対効果を発揮します。
Google Cloud AIが公開した判別モデル連携の設計は、エージェント運用の採算性に悩む現場にとって極めて合理的な指針です。ミリ秒単位で二値判定を下す判別モデルと、思考レベルを抑制したGemini 3.8 Flashの組み合わせは、成功タスクあたりの費用対効果を確実に引き上げます。
この構成が向いているのは、コーディングエージェントや多段階の業務ワークフローなど、1回のタスクで多数のAPIコールが発生するシステムです。一方で、1日あたりの呼び出し回数が少ないサービスや単純な問い合わせ窓口では、インフラ管理やルーティング設計の手間が削減費用を上回ります。自社のタスク頻度と総コスト構造を見極めたうえでの採用判断が賢明です。
よくある質問
Q: 判別モデルを挟むとシステム全体の応答遅延が長くなりませんか?
A: 判定の遅延はごくわずかです。TypeSafe Jevなどの判別モデルは70msから500msの短時間で結果を返します。Geminiが不要な思考を行う時間を回避できるため、エージェント全体の処理時間はむしろ短縮されるケースが多く見られます。
Q: DiffusionGemmaを動かすには高価なGPUサーバーが必要ですか?
A: Compute EngineのL4 GPUインスタンスやCloud Run環境で十分に動作します。オープンウェイトモデルとして軽量に設計されているため、大規模なクラスタを用意する必要はありません。小規模な構成からセルフホストを始められます。
Q: GeminiのThinking機能は完全にオフに設定できますか?
A: モデルの仕様に応じた柔軟な設定に対応しています。Gemini 3.8 Flashなどは thinkingLevel にLOWを指定することで思考トークンの消費を最小化できます。タスク難易度に応じた適切なレベル選択がコスト管理の直結要素です。
Q: コンテキストキャッシュを利用するために特別なコード記述は必要ですか?
A: Interactions APIを利用していれば暗黙的キャッシュが標準で自動適用されます。4,096トークン以上の共通コンテキストが存在する場合、明示的なキャッシュ作成コードを書くことなく割引を享受できる仕組みです。
まとめ
自律型AIエージェントの費用対効果を高める運用ポイントは以下の3点に集約されます。
- 1フォワードパスで動く安価な判別モデル(JevやDiffusionGemma)を前段に置き、不要な推論モデルの呼び出しを阻止する
- Geminiの思考設定は
thinkingLevel: "LOW"を基準とし、思考トークンの過剰消費を抑える - 75%から90%の割引効果を持つコンテキストキャッシュを維持するため、文脈の長いタスクはモデルを固定して運用する
まずは現在運用しているエージェントのログを確認し、GeminiのThinkingレベルが過剰に設定されていないか見直すことから始めてみてください。
コメント