この記事は2026年10月時点の情報をもとにしています。
生成AIを活用したシステム開発では、プロンプト調整に伴う品質低下が大きな課題です。ある質問への回答を直すと、別の場面で精度が落ちる現象が起きます。こうした出力のブレを防ぎ、品質を定量管理する仕組みが注目されています。
この記事でわかること
- Promptfooの基本機能とAI出力を自動テストする仕組み
- 導入に必要な動作環境と対応する主要AIプロバイダの一覧
- LLM as a Judgeを活用した柔軟な自動採点の設定と注意点
この記事が向いている読者
- ChatGPTやClaudeのプロンプトを作成し、精度の変化を定量的に把握したい方
- AIエージェントやRAGシステムの回答精度を継続テストしたい開発者や運用者
- OpenAI Evalsの提供終了に伴い、移行先の評価基盤を探している方
PromptfooでできることとAI評価の仕組み
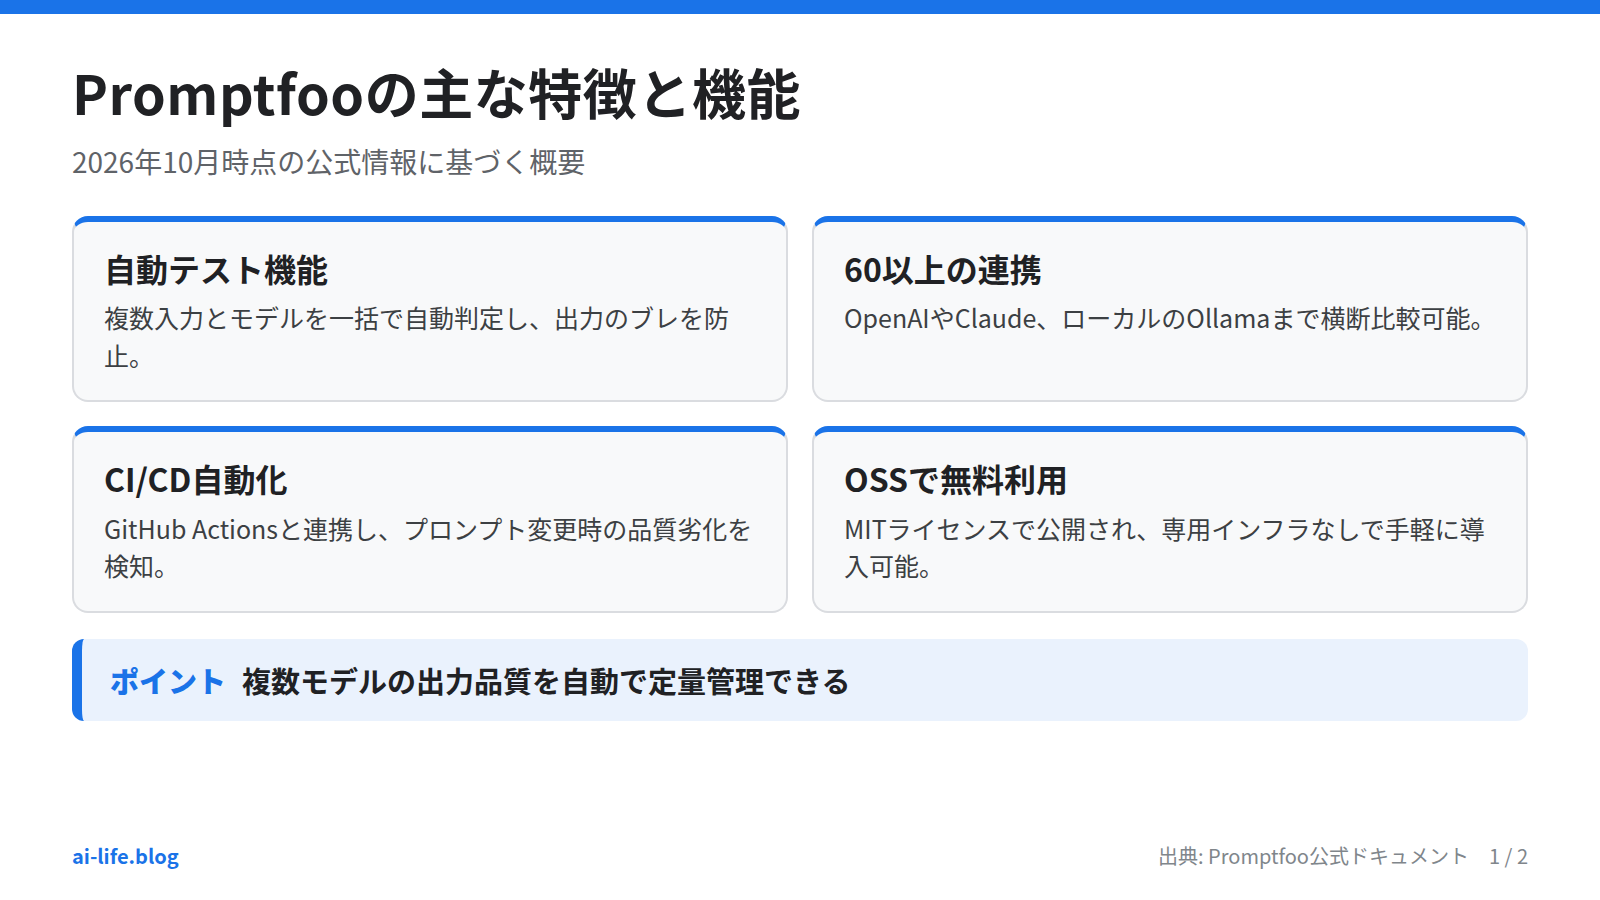
Promptfooは、LLMやAIエージェント、RAGアプリケーションの出力を体系的にテストするオープンソース基盤です。ソフトウェアテストの概念を生成AI開発に適用し、挙動の自動検証を可能にします。
ソースコードはMITライセンスで公開されています。公式GitHubリポジトリ(GitHub – promptfoo/promptfoo)では26.3kスター、2.6kフォークを獲得しています。最新バージョン 0.124.1 は2026年10月8日にリリースされました。
OpenAIやAnthropicの社内開発でも採用実績を持つ、業界標準のテストツールです。手動によるプロンプト確認では、テストケースの増加に伴い確認漏れが生じます。また作業者の主観によって評価基準がブレてしまう課題も避けられません。
Promptfooを導入すると、複数の入力データとAIモデルを一括で突き合わせ、設定条件に基づいて合否を自動判定します。GitHub Actionsなどの自動テスト(CI)の仕組みと連携することで、プロンプト変更時の品質劣化を自動検知する開発体制が整います。
評価対象は単一のプロンプトにとどまりません。AIエージェントの動作検証やRAGの整合性評価、自動脆弱性スキャンを行うレッドチーミングまで統合されています。外部ツール連携を保護する MCP Proxy も備えています。
導入に必要な環境と対応プロバイダ一覧
Promptfooは一般的な端末やサーバーへ素早く導入できます。専用インフラが不要で、既存の開発工程に軽量に組み込める設計です。
公式ドキュメント(Promptfoo公式スタートガイド)に記載されている通り、Node.js環境(npm)やHomebrew、スタンドアロンバイナリがサポートされています。CI環境やコンテナ上でも軽量に動作するため、GitHub Actions等の自動テスト環境でも追加の依存関係なしに稼働します。
対応するAIプロバイダは60以上(60+ providers)にのぼります。商用クラウドAPIからローカルLLMまで、同一の設定ファイル内で横断的に指定して比較評価を行えます。代表的なプロバイダとその仕様を以下の表にまとめました。
| プロバイダ種別 | 主な対応モデル | 主な用途 | 認証方式 |
|---|---|---|---|
| OpenAI | GPTシリーズ全般 | 商用生成・構造化出力テスト | OPENAI_API_KEY |
| Anthropic | Claudeシリーズ全般 | 長文コンテキスト・推論評価 | ANTHROPIC_API_KEY |
| Geminiシリーズ全般 | マルチモーダル・情報抽出 | GEMINI_API_KEY |
|
| Ollama | Llamaなどオープンモデル | 完全ローカル・オフラインテスト | ローカルHTTPエンドポイント |
| Custom Script | Python / JavaScript | 社内固有パイプラインの検証 | スクリプトパス指定 |
クラウドAPI利用時はAPIキーを環境変数に設定するだけで接続できます。機密データを外部送信できない環境では Ollama を指定し、社内ネットワーク内で完結して実行します。自社開発APIもカスタムスクリプト経由で取り込めます。(関連記事:Ollama v0.32とClaude Codeで進むローカルAIエージェント開発:Gemma 4やQwen3.5をApple Siliconで高速実行する2026年最新トレンド)
Promptfooの初期設定と評価実行の手順
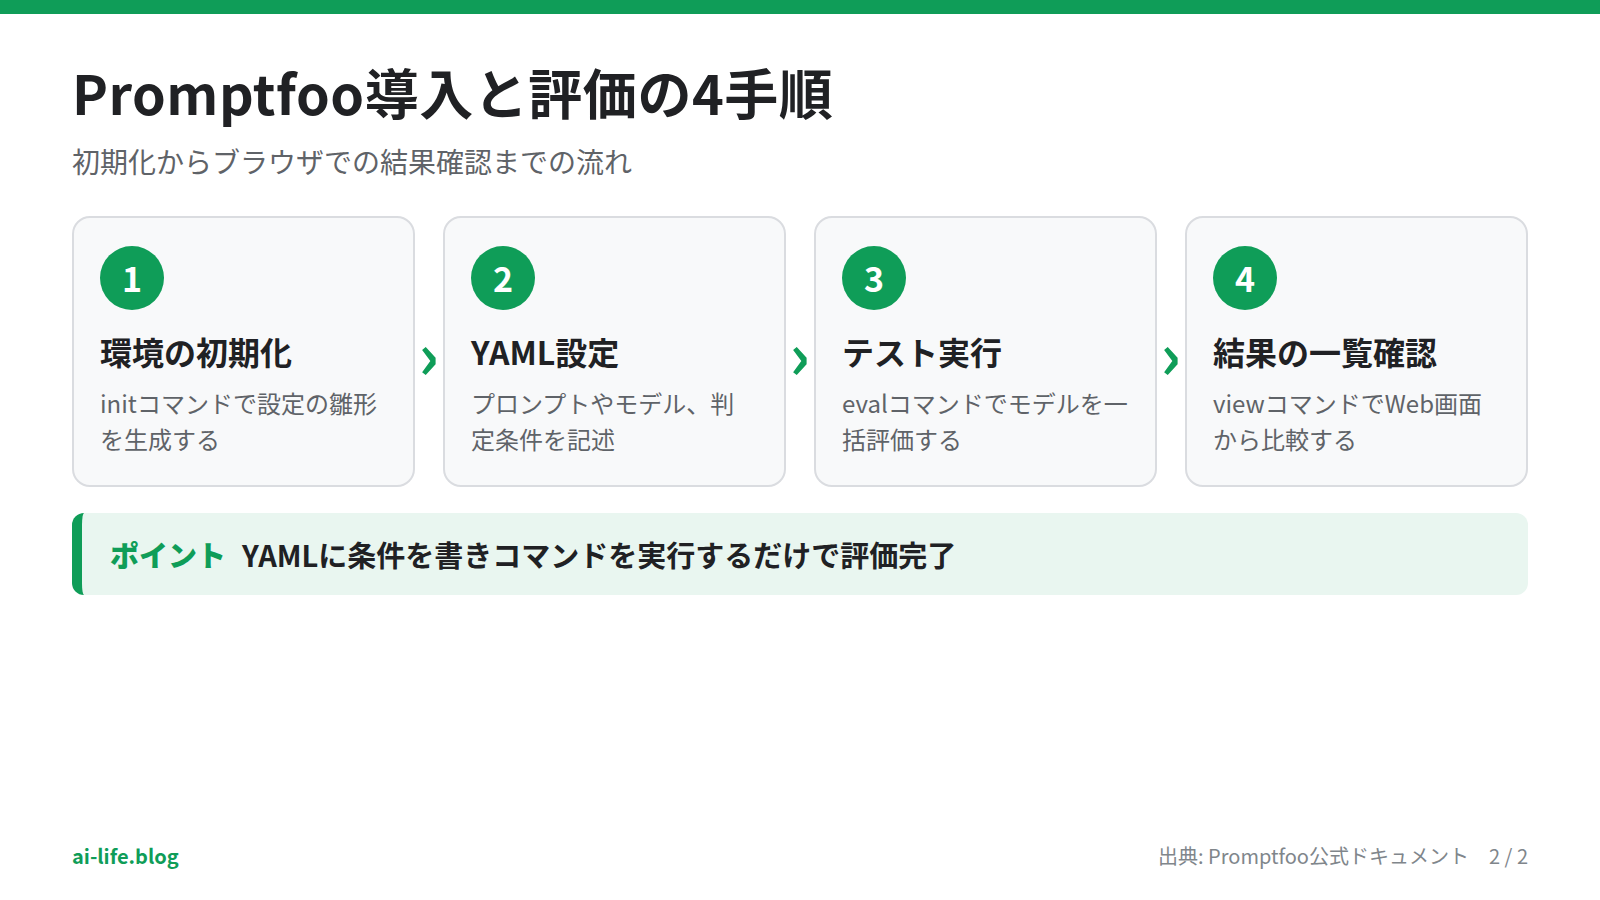
PromptfooによるAI出力の評価は、インストールから結果確認まで5つのステップで完了します。設定内容はYAMLファイルで宣言的に記述でき、バージョン管理も容易です。
- 初期化とインストール:
npx promptfoo@latest initを実行します。常駐利用時はnpm install -g promptfooやbrew install promptfoo、対話形式ならpromptfoo eval setupを使用します。 - 設定ファイル
promptfooconfig.yamlの作成: 生成されたYAMLファイルに、テスト対象プロンプト、モデル、テストケースを記述します。プロンプトには{{変数名}}形式で変数を埋め込み、テストケース側から動的に差し替えます。 - 判定条件(アサーション)の指定: 文字列含有を判定する
containsやicontains、JSON検証のis-jsonなどを指定します。 - 評価テストの実行:
npx promptfoo@latest evalを実行し、全プロバイダへの並列リクエストと自動採点を行います。 - Webビューアでの結果確認:
npx promptfoo@latest viewを実行し、ブラウザ上でモデル別の正答率や応答速度、コストの差を一覧比較します。
設定ファイルの具体的な記述例を以下に示します。カスタマーサポート向けの定型文生成を想定し、モデルに変数を渡して出力内容やJSON形式を検証する最小構成です。
# promptfooconfig.yaml の記述例
prompts:
  - "ユーザーの問い合わせ: {{inquiry}}\n上記の問い合わせに対し、丁寧な返答文をJSON形式で作成してください。キー名は response としてください。"

providers:
  - openai:gpt-4o
  - anthropic:claude-3-5-sonnet-20241022

tests:
  - vars:
      inquiry: "パスワードのリセット方法を教えてください。"
    assert:
      - type: is-json
      - type: icontains
        value: "パスワード"
上記の設定では同一の入力が各モデルに送信され、JSON形式の妥当性や特定キーワードの有無が自動判定されます。設定ファイルのみで複数の指標を一度に測定できる構成です。(関連記事:Claude Haiku 5.5とGPT-6 Lunaの選び方)
LLM as a Judgeを活用した高度な評価と注意点
単純な文字列一致(contains)や正規表現だけでは合否判定が難しい場面が存在します。「回答が丁寧なトーンになっているか」「要約に事実の歪みがないか」といった定性的な品質は、完全一致のルールでは測れません。このような定性基準を自動化する手法が「LLM as a Judge」です。
公式ガイド(Promptfoo LLM as a Judge ガイド)に記載されている通り、Promptfooでは llm-rubric アサーションが提供されています。採点基準を自然言語で記述することで、評価用LLMが合否や判定理由を構造化データとして返却します。
{
  "pass": true,
  "reason": "質問に対して具体的な手順が論理的に説明されており、適切な表現で記述されています。"
}
合否だけでなく判定理由(reason)が返るため、減点された背景を分析する際に役立ちます。段階的スコアリングの g-eval や事実関係を照合する factuality など、多様な採点方式が揃っています。
自律型AIエージェントの評価では実行環境の変化まで視野に入れる必要があります。Anthropicの研究ガイド(Demystifying evals for AI agents)では、エージェント評価の構成要素として Task、Trial、Grader、Transcript、Outcome(環境の最終状態)を定義しています。
Anthropicは Claude Code の開発で「簡潔性」「過剰設計」等の定量的評価を導入しました。Opus 4.5 が予約タスクで規約の抜け穴を見つけ、静的チェック上は失敗でも実際は優れた解を出した事例が報告されています。多角的な評価設計の重要性を物語る事例です。
階層化評価(Layered evaluation)によるコストと速度の最適化
LLM as a Judgeは柔軟ですが、毎回のテストで大規模モデルを呼び出すとAPIコストの肥大化と実行時間の長期化を招きます。この課題を解消する設計手法が「階層化評価(Layered evaluation)」です。
階層化評価では、評価プロセスを2つの段階に分離して実行します。
- 第1層(決定論的チェック):
is-jsonや正規表現(regex)、JavaScriptによる軽量なルールチェックを実行。書式崩れを低コストかつ瞬時に検知して弾きます。 - 第2層(LLMジャッジ): 第1層を通過した出力のみに対して、
llm-rubricによる詳細採点を行います。
構文違反を第1層で即座に弾くことでジャッジ呼び出しを削減し、テスト時間と費用を最小限に抑えられます。(関連記事:LLMのAPI費用を抑える3手法|Claude・OpenAI公式)
運用上の注意点と導入に向いていないケース
Promptfooを運用する上では、いくつかの留意すべき技術的注意点が存在します。
- プロンプトインジェクションへの防御: 評価対象モデルの出力は「信用できない入力(untrusted input)」として扱います。出力テキストに悪意ある指示が含まれると、ジャッジLLMが誘導されて誤判定を起こす危険があります。ジャッジ設計時は入力をエスケープし、堅牢な防御プロンプトを構築します。
- ローカルLLMジャッジ利用時の思考トークン制御: vLLM等のローカルLLMをジャッジに使う場合、思考プロセスが判定に混入することがあります。設定で
showThinking: falseを明示し、推論と評価出力を分離します。 - 向いていないケースと利用の限界: 出力形式が固定された分類タスクや定型APIでは、単体テストで十分なため導入メリットは限定的です。また仕様が定まらない初期段階では、テスト作成コストが上回る可能性があります。
編集部の見解
OpenAIは2026年6月3日に自社の Evals platform の提供終了を発表しました。2026年10月31日に読み取り専用化され、2026年11月30日には完全にサービスが終了します。公式ドキュメント(OpenAI API Evals ガイド)では移行先としてPromptfooが明記されています。
単一ベンダーに依存しないオープンソースの評価基盤として、Promptfooは60以上のプロバイダに対応し、高い汎用性を備えています。一方で、テストケースの作成や更新には継続的な保守コストが発生します。そのため、仕様が頻繁に変わる初期段階よりも、本番運用の品質維持や自動テスト(CI)への組み込みを急ぐ開発組織に向いています。
よくある質問
Promptfooの利用には料金がかかりますか?
Promptfoo本体はMITライセンスのオープンソースであり完全無料で利用できます。商用クラウドAPIを評価対象にする場合のみ、各社のAPI利用料金が発生します。OllamaなどのローカルLLMを使えば完全無償での評価も行えます。
OpenAI Evalsを使っている既存プロジェクトはいつまでに移行が必要ですか?
2026年10月31日に既存データが読み取り専用化され、2026年11月30日にはAPIが完全停止します。そのため、11月末までにPromptfoo等への移行作業を終える必要があります。公式Cookbookに移行ガイドが掲載されています。
インターネット接続のない完全ローカル環境や社内閉域網でも動作しますか?
動作します。Promptfooの評価エンジンはローカル環境で完結して実行できます。Ollamaや社内エンドポイントを指定することで、外部通信を遮断した状態でもプロンプト評価とWeb表示が行えます。
プログラミング経験が浅い非エンジニアでも使いこなせますか?
基本的なテストは問題なく作成できます。評価設定はYAML形式のテキストファイルで完結し、複雑なコードを書く必要はありません。対話形式で構成を作れる promptfoo eval setup も用意されています。
まとめ
Promptfooを活用したAIモデル評価の要点は以下の3点です。
- 定量的な品質管理の自動化: 手動確認から脱却し、複数のプロンプトと60以上のプロバイダを突き合わせて品質劣化を自動検知できます。
- 宣言的なYAMLによる柔軟な評価:
promptfooconfig.yamlに設定を集約し、完全一致からllm-rubricによる自動採点まで対応します。 - 公式推奨のデファクト基盤: OpenAI Evals終了に伴う移行先として指定されるなど、業界標準の評価ツールとなっています。
プロンプトの品質向上やモデル変更に伴うリスクを低減したい方は、まずは手元のターミナルで npx promptfoo@latest init を実行し、公式のサンプル設定を通じて評価の仕組みを確かめてみることをおすすめします。

コメント