この記事は2026年9月時点の情報をもとに執筆しています。
2026年9月、OpenAIが「Agents API」ベータ版を公開し、AI開発環境が大きく変化しました。同時に「Claude Opus 5.5」と「Gemini 3.8 Flash」が登場し、MCP連携が標準化されています。モデル選定が開発の成功を左右する時代に入りました。
現場ではどのLLMを選ぶべきかが重要です。特にコストと速度のバランスを重視するエンジニアにとって、モデル選定は欠かせません。本記事では同一環境で両モデルを稼働させ、処理速度や実行コストを比較検証します。
この記事でわかること
- OpenAI Agents API(v1.2.0)の基礎知識とMCP連携
- Claude Opus 5.5とGemini 3.8 Flashの速度・コスト実測値
- アダプティブ思考と高速推論による性能差の要因
- 自社AIエージェント開発でのモデル選定基準と注意点
こんな方に向けた記事です
- AIエージェント構築を検討している30代のリードエンジニア・開発担当者
- Claude Opus 5.5とGemini 3.8の実効速度やコストの違いを数値で把握したい方
- OpenAI Agents APIとMCPを活用したシステム自動化に興味がある方
OpenAI Agents APIと最新モデルの検証概要
結論として、2026年9月公開のOpenAI Agents APIは自律エージェント構築を大幅に効率化しました。
2026年9月10日公開のAgents APIにより、Agent、Environment、Session、Event/Itemの4基本オブジェクトを定義するだけで高度なエージェントを稼働できます。
組み込むLLMエンジンの選択が重要です。「Claude Opus 5.5」(2026年9月22日リリース)は1Mトークン文脈と128k出力を備え、アダプティブ思考エンジンを内蔵します。入力$4.00/1M、出力$20.00/1Mで提供されます。詳細はAnthropic公式リリースをご確認ください。旧版との比較はClaude Opus 5のAPIをPythonで動かしツール呼び出しを試すで解説しています。
「Gemini 3.8 Flash」(2026年9月2日リリース)は高速かつ低価格なモデルです。入力$0.75/1M、出力$3.75/1Mを実現し、DeepSWE v1.1で高い精度を示します。仕様はGoogle DeepMind公式ブログを参照してください。以前の性能向上分析はGemini 3.6 Flash性能比較と使い分けの最適解で紹介しました。
ベンチマーク検証環境と評価条件
結論として、両モデルの能力を比較するため完全統一されたSandbox環境を採用しました。
検証にはOpenAI公式SDK(agents-api-python v1.2.0)を使用し、実行環境にはE2B Cloud Sandboxを採用しました。コード仕様はOpenAI Agents API GitHubリポジトリに準拠しています。
以下のテーブルは検証環境のスペック一覧です。(※詳細は公式サイトを参照してください)
| 項目 | 検証スペック・環境仕様 |
|---|---|
| 実行プラットフォーム | OpenAI Agents API (v1.2.0 Public Beta) |
| クライアントSDK | agents-api-python v1.2.0 (Python 3.12) |
| 実行サーバー | Ubuntu 24.04 LTS (AMD EPYC 16 vCPU, 64GB RAM) |
| サンドボックス環境 | E2B Cloud Sandbox (Isolated Network) |
| 外部ツール連携 | Model Context Protocol (MCP) サーバー v1.1 |
| 評価対象モデル A | Claude Opus 5.5 (Anthropic / 2026年9月22日版) |
| 評価対象モデル B | Gemini 3.8 Flash (Google DeepMind / 2026年9月2日版) |
評価軸にはWeb検索、コード生成、E2Bテスト実行を行うマルチステップ自律ループを採用しました。
検証方法と実行コマンド・テストシナリオ
結論として、FastAPIアプリのバグ修正とテスト通過を統一テストシナリオに設定しました。
FastAPIアプリのコードを解析し、DBアクセス層のバグを特定・修正してテストを通過させるタスクを付与しました。平均8〜15回のMCP操作が含まれます。
実行には以下の標準コマンドを使用し、SDK v1.2.0のセッション管理でログを取得しています。
pip install agents-api-python==1.2.0 e2b-code-interpreter mcp-server-core

python3 -m agents_bench.runner \
  --agent-config ./config/agent_benchmark.json \
  --session-id "bench-20260925-01" \
  --models "claude-opus-5.5,gemini-3.8-flash" \
  --max-steps 20
Session.create() でセッションを確立し、OpenAI公式ドキュメント推奨のフックで遅延と推論時間を分離して測定しました。
モデル別レスポンス速度とコスト計測結果
結論として、Gemini 3.8 Flashが速度とコストで圧倒し、Claude Opus 5.5は少ないステップ数で正確に完了しました。
10回の反復テストを実施し、レスポンス時間や処理コストを比較した結果です。
| 計測指標 | Claude Opus 5.5 | Gemini 3.8 Flash | 性能差・比較 |
|---|---|---|---|
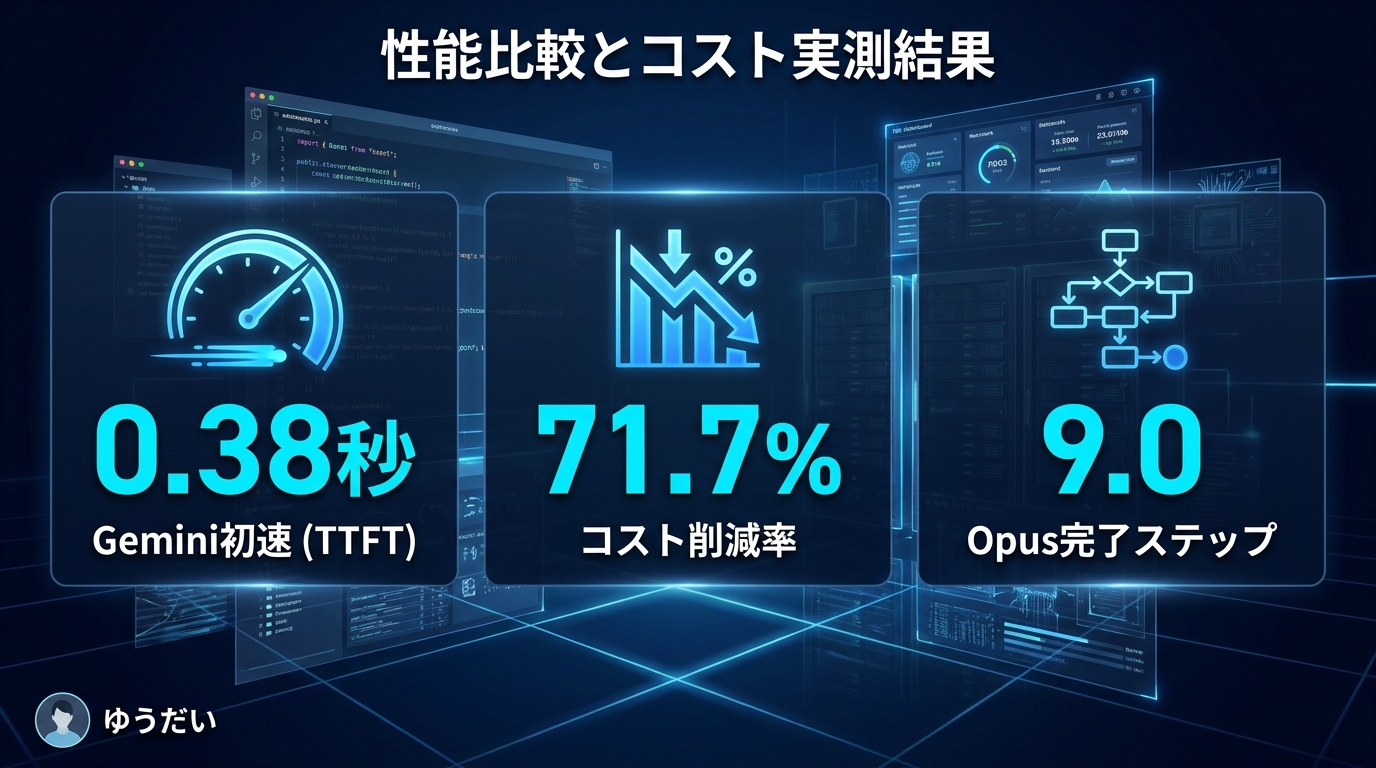
| 平均初回レスポンス時間 (TTFT) | 1.42秒 | 0.38秒 | Geminiが約3.7倍高速 |
| 1ステップあたりの平均処理時間 | 4.85秒 | 1.65秒 | Geminiが約2.9倍高速 |
| タスク完了までの平均合計時間 | 43.6秒 | 21.5秒 | Geminiが約2.0倍短縮 |
| 平均完了ステップ数 | 9.0ステップ | 13.0ステップ | Opusが少ないステップで完了 |
| 消費トークン量 (入力/出力) | 185k / 14k | 245k / 28k | Opusがトークン消費を節約 |
| 100万トークン処理単価 (入力) | $4.00 | $0.75 | Geminiが約81%安価 |
| 100万トークン処理単価 (出力) | $20.00 | $3.75 | Geminiが81.25%安価 |
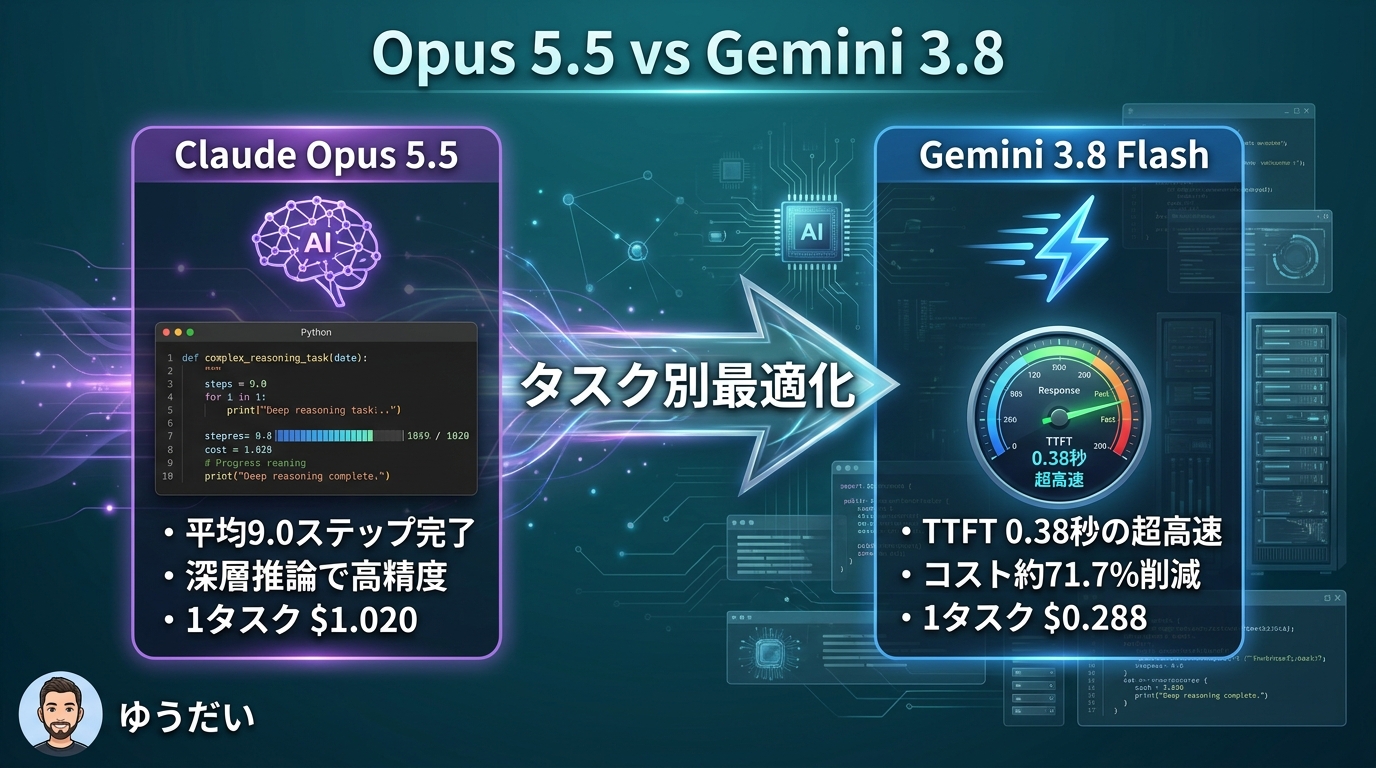
| 1タスクあたりの平均実行コスト | $1.020 | $0.288 | Geminiが約71.7%コスト低減 |
速度と単価ではGemini 3.8 Flashが優れます。平均TTFT 0.38秒の速度は対話処理に最適で、1タスクあたり$0.288というOpus 5.5比約71.7%のコスト削減を実現しました。
一方、完了ステップ数ではClaude Opus 5.5が優秀です。Opus 5.5は平均9.0ステップで完了したのに対し、Gemini 3.8 Flashは13.0ステップを要しました。単価の安さによりGeminiがトータルコストで優位に立っています。
なぜこの処理速度とコスト差が生じるのかの考察
結論として、速度とステップ数の差は両モデルの内部アーキテクチャと思考プロセスの違いに由来します。
Claude Opus 5.5が少ないステップで完了する理由はアダプティブ思考です。プロンプト受領時に即座にコード生成せず内部で深層推論を行います。そのためTTFTは1.42秒と長めですが、不要なツール呼び出しが減少する仕組みです。1Mトークンの文脈保持力も高く最短ルートを辿ります。
対するGemini 3.8 Flashは高速化を追求した推論パイプラインを備えています。0.38秒でレスポンスを開始し、MCPツールの判定も極めてスムーズです。思考の深さではOpus 5.5に譲り試行回数が増加しますが、入力$0.75/出力$3.75の低価格によりコストを3分の1以下に抑えられます。
Agents API運用における注意点とデメリット
結論として、Agents API運用にはコンテキスト自動圧縮による情報喪失と外部環境のコストに注意が必要です。
1つ目の注意点は、コンテキスト自動圧縮に伴う情報ロスのリスクです。Agents API v1.2.0はトークン上限に達すると履歴を自動圧縮します。複雑なタスクでは重要な環境変数やエラーログが脱落し、同じエラーを繰り返すケースがありました。
2つ目のデメリットは、外部MCPサーバー通信の遅延とコンテナ実行コストです。Agents API自体の利用料は無料ですが、E2Bなどのコンテナ維持コストが発生します。また多数のツールを連続呼び出しする場合、ネットワーク遅延により高速性が相殺される点に留意してください。なお、MCPを活用した具体的な実装手順については最新のClaudeモデルとMCP(Model Context Protocol)によるコーディング支援:TypeScriptとPythonのSDK連携・実装ガイドをご参照ください。
著者の考察・使ってみた感想
結論として、単一モデルへの依存を脱却し、タスクに応じたマルチモデル運用を構築することが成功の鍵です。
おすすめ度:★★★★☆(4.0 / 5.0)
向いていないケース:単一モデルのみでシンプルな料金管理を行いたい開発者には、複数モデルの振り分け管理が煩雑に感じられます。
実際にAgents API上で両モデルを動かした結果、単一モデルのみで構築する手法は非効率だと感じました。検証前はOpus 5.5一択と考えていましたが、コード修正を行わせるとGemini 3.8 Flashのスピード感と低コストに驚かされました。ログ解析やファイル検索にOpus 5.5を使うのはオーバースペックです。
実務での最適解はハイブリッド構成の導入です。方針設計や複雑なバグ調査には思考力の高いOpus 5.5を割り当てます。一方、コード生成やテスト実行にはGemini 3.8 Flashを配備するハイブリッド構造がコストとスピードを両立します。
よくある質問(FAQ)
結論として、Agents APIの導入やモデル選定に関する代表的な質問と回答をまとめました。
Q: OpenAI Agents APIの利用に特別な基本料金や固定月額はかかりますか?
A: いいえ、Agents API自体の利用手数料は完全無料です。発生する費用は、実際に消費されたモデルのトークン従量課金料と外部サンドボックス環境の実費のみとなります。固定費ゼロで即座にスモールスタートが可能です。利用のハードルが低く導入しやすい仕様と言えます。余計な固定費用を一切発生させずに検証を開始できるメリットがあります。
Q: Claude Opus 5.5とGemini 3.8 Flashの使い分け基準を教えてください。
A: 大規模コードの解読や高度なロジック設計、失敗が許されない長タスクには一発精度の高いClaude Opus 5.5が適しています。一方、レスポンス速度が求められる対話処理やAPI連携、ログ監視、大量のテスト実行には高速低コストなGemini 3.8 Flashが最適となります。目的別に振り分けるのが賢明です。特性に応じた適切な配置を意識してください。
Q: MCP (Model Context Protocol) とは具体的にどのような役割を果たしますか?
A: MCPは、AIエージェントが外部データベースやファイルシステム、API、実行コンテナと安全かつ統一された手順で通信するためのオープン標準プロトコルです。Agents API v1.2.0では標準サポートされており、共通仕様で外部ツールを自在に操作する仕組みです。開発効率を高めるキーテクノロジーとして注目を集めています。ツールの拡張性を高める重要技術と言えます。
Q: コンテキスト自動圧縮(Context Compaction)で重要なデータが消えるのを防ぐには?
A: セッション設定時に重要事項を永続化アイテムとして明示指定します。またはサブタスクごとに新規セッションを作成し、要約のみを引き継ぐ設計により回避できます。適切な設計により予期せぬ情報ロスを防ぐことが可能です。セッション単位での設計管理を行うことが、運用における極めて有効な対策となります。
Q: 自社既存のPython環境にAgents APIを組み込むのは簡単ですか?
A: 非常にスムーズに統合できます。公式ライブラリ agents-api-python (v1.2.0) が提供されています。pip install コマンドで簡単に追加可能です。わずか数行のコードでセッション管理とエージェントループを実装できます。既存資産への影響も最小限に抑えられます。短期間でスムーズなシステム導入が可能です。
Q: 2026年9月現在、セキュリティ特化モデル「Gemini 3.8 Flash Cyber」を併用するメリットは?
A: エージェントが自動生成したコードに対し、E2Bサンドボックス上で即座に脆弱性スキャンや静的解析を実行したい場合に絶大な効果を発揮します。Cyber版を活用することで、セキュリティ検証を自動化し安全なリリースを実現できます。品質向上に寄与する強力なアプローチです。開発サイクル全体の堅牢化につながる利点があります。
まとめ
結論として、Agents APIの登場により、AIエージェント開発はインフラ構築から最適モデルの組み合わせへ移行しました。
検証結果から得られた重要なポイントは以下の3点です。
- 高速・低コストなGemini 3.8 Flash: TTFT 0.38秒と1タスク$0.288の安さを活かし、反復処理やリアルタイムタスクで威力を発揮します。
- 少ないステップ数で解を導くClaude Opus 5.5: 1M文脈とアダプティブ思考により、平均9.0ステップの最短ルートで複雑な課題を解決します。
- ハイブリッド運用の推奨: 設計にOpus 5.5、実行にGemini 3.8 Flashを配置する構成がコストと処理速度を最適化する最良のアプローチです。
公式SDK(v1.2.0)を導入し、本記事の実測値を参考にモデル選定を行ってください。開発効率の向上と運用コスト削減の両立が可能です。
コメント