この記事は2026年10月時点の情報をもとにしています。
AIを活用した業務自動化やシステム開発で、多くのエンジニアが悩むのがAPI利用料金です。プロトタイプから本番稼働へ移行し処理量が増えると、請求額は一気に跳ね上がります。
主要なAIプロバイダーは、コスト削減に直結する公式機能を提供中です。これらを適切に組み合わせれば、回答品質を維持したまま支出を大幅に圧縮できます。
この記事でわかること
- Claudeのプロンプトキャッシングによる入力料金90%削減の仕様
- OpenAIのBatch APIを活用して非同期処理を一律半額にする手順
- LiteLLMとOpenAI公式の予算制限機能を用いたAPI費用の暴走防止策
この記事が向いている読者
- LLMのAPI課金額を抑えながら本番運用を進めたいエンジニア
- 社内ツールのトークン費用最適化を担当する技術リーダー
- 自前のAI自動化ワークフローの運用コストを見直したいビジネスパーソン
LLMのAPI費用を削減する3つの公式手法一覧
LLMのAPIコストを削るには、処理要件に合わせて公式機能を使い分ける必要があります。主要な割引制度と管理手法を一覧表で整理しました。
| 手法 | 提供元 | 割引率・効果 | 適した用途 | 主な制限・仕様 |
|---|---|---|---|---|
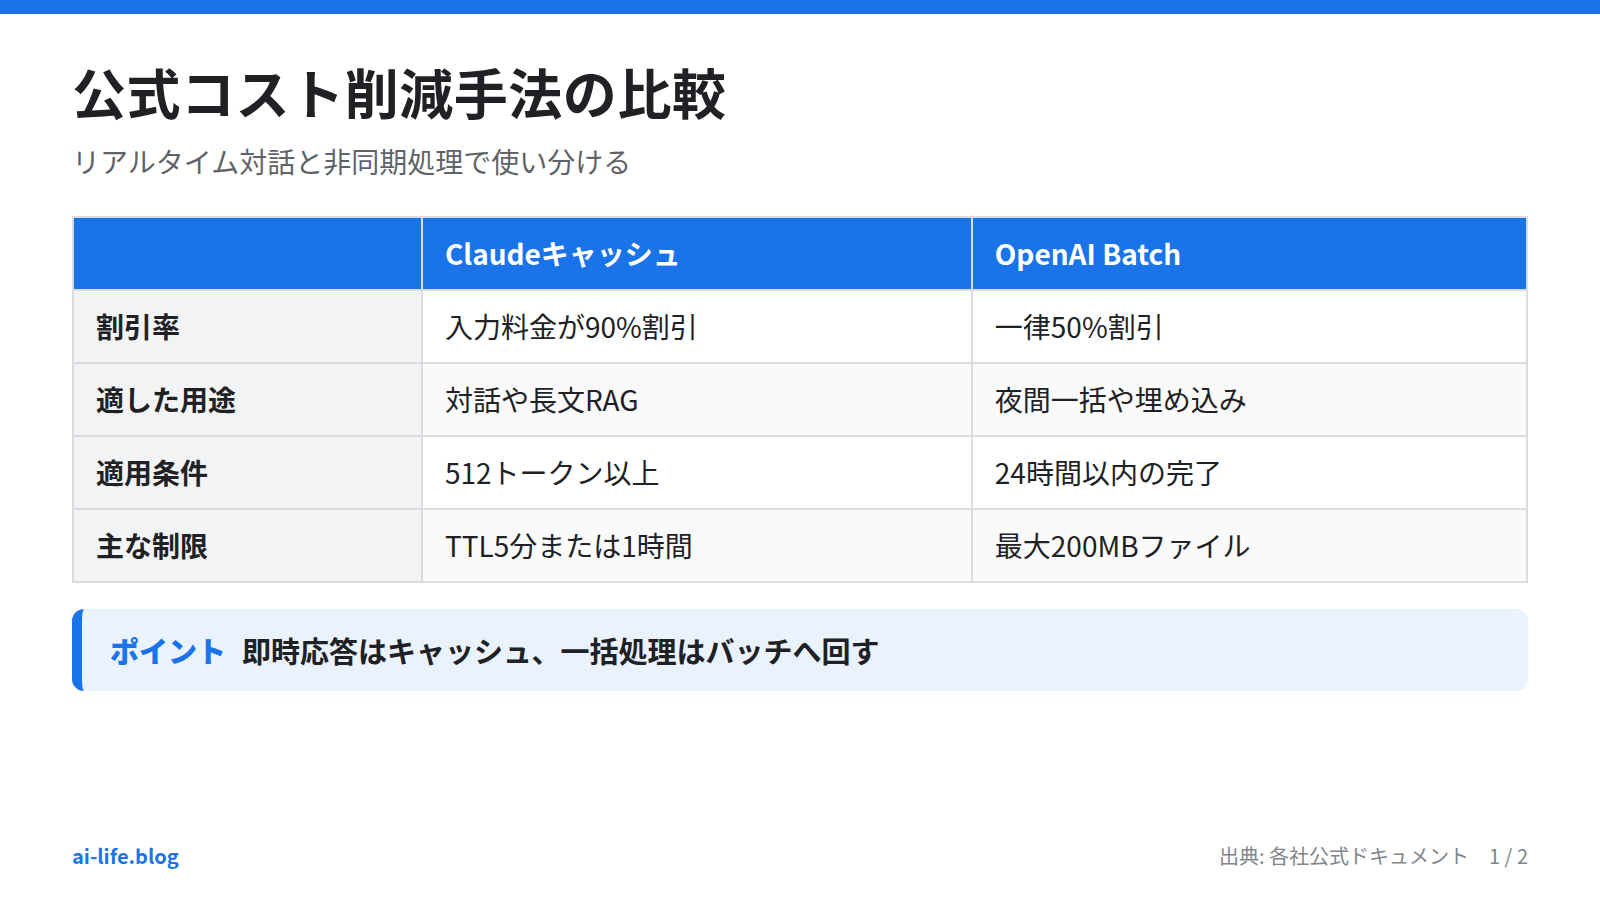
| プロンプトキャッシング | Anthropic(Claude) | キャッシュ読取時に入力料金が90%割引 | 長文指示や社内文書を毎回送る対話・RAG | 最小512トークン、TTLは5分または1時間 |
| Batch API | OpenAI | 通常同期API比で一律50%割引 | 夜間データ分類、埋め込み生成、一括評価 | 24時間以内の非同期完了、最大200MBのJSONL |
| ゲートウェイ支出管理 | LiteLLM Proxy | 予算上限での自動遮断とマルチ階層可視化 | 複数人や複数チームでのAPI相乗り運用 | プロキシサーバーの構築・運用が必要 |
3つのアプローチは併用できます。リアルタイム対話にはキャッシュを効かせ、即答が不要な一括処理はバッチへ回し、基盤全体をゲートウェイで統制するのが賢い構成です。
推論コストを削るためにモデル性能を落とすと、回答精度の低下を招きかねません。高品質なモデルのまま支出を最小化するには、公式の割引制度を正しく活用する構成が有効です。(関連記事:2026年9月AI動向まとめ|自律エージェントと最新モデル仕様)
Claudeのプロンプトキャッシングで入力費用を90%削減
AnthropicのClaude APIには、共通のプロンプト接頭辞をメモリ上に保持する「プロンプトキャッシング」が標準搭載されています。同一指示文や長大資料を繰り返し送信する構成において、入力トークン費用の大幅削減を実現します。
キャッシュがヒットした読み取りトークン料金は、通常入力料金のわずか0.1倍(90%割引)です。共通ドキュメントを読み込ませる構成では、通信ごとの費用を10分の1近くまで抑え込めます。
公式ドキュメントで規定されている基本仕様は次の通りです。
- 対象モデルと最小トークン長: Claude Opus 5.5やSonnet 5.5、Haiku 5.5等に対応します。512トークン以上のプレフィックスから適用対象です。
- TTL(保持期間): 標準5分(リクエスト到達ごとに自動延長)と、長時間バッチ向けの拡張1時間(書込費用2.0倍)の2種類を用意。
- 書込時の追加コスト: 初回のキャッシュ生成時には、5分TTLで通常入力料金の1.25倍、1時間TTLでは2.0倍の費用が発生します。
- 自動キャッシング:
cache_control={"type": "ephemeral"}を最上位に指定します。会話進行に合わせてブレークポイントが自動追従。 - 効果測定: レスポンスの
usageを参照します。cache_read_input_tokensから削減効果を集計可能。
プロンプトキャッシングを活用する際は、コンテキストの配置順序に注意が必要です。キャッシュは先頭から一致している部分にのみ機能するため、可変の質問文を先頭に置くと後続の共通文書がキャッシュされません。
システム指示などの不変データを先頭に置き、ユーザー発言は末尾に配置してください。実装仕様はClaude Prompt Caching公式ドキュメントで確認できます。(関連記事:Claude Haiku 5.5とGPT-6 Lunaの選び方)
注意点と向いていないケースは以下の通りです。
- リクエスト間隔が5分以上空く散発的なアクセスではキャッシュが切れ、1.25倍の書込費用が重なり逆効果になります。
- 送信する共通コンテキストが512トークン未満の短いプロンプトではキャッシュ機能が働きません。
- 毎回異なる文書を参照する単発処理には向いていません。
OpenAIのBatch APIで非同期処理を一律半額にする
即座に結果を返す必要がないバックグラウンド処理では、OpenAIのBatch APIが最も強力な選択肢です。リクエストをファイルでまとめて投入することで、通常の同期API料金から一律50%割引(半額)で推論を実行できます。
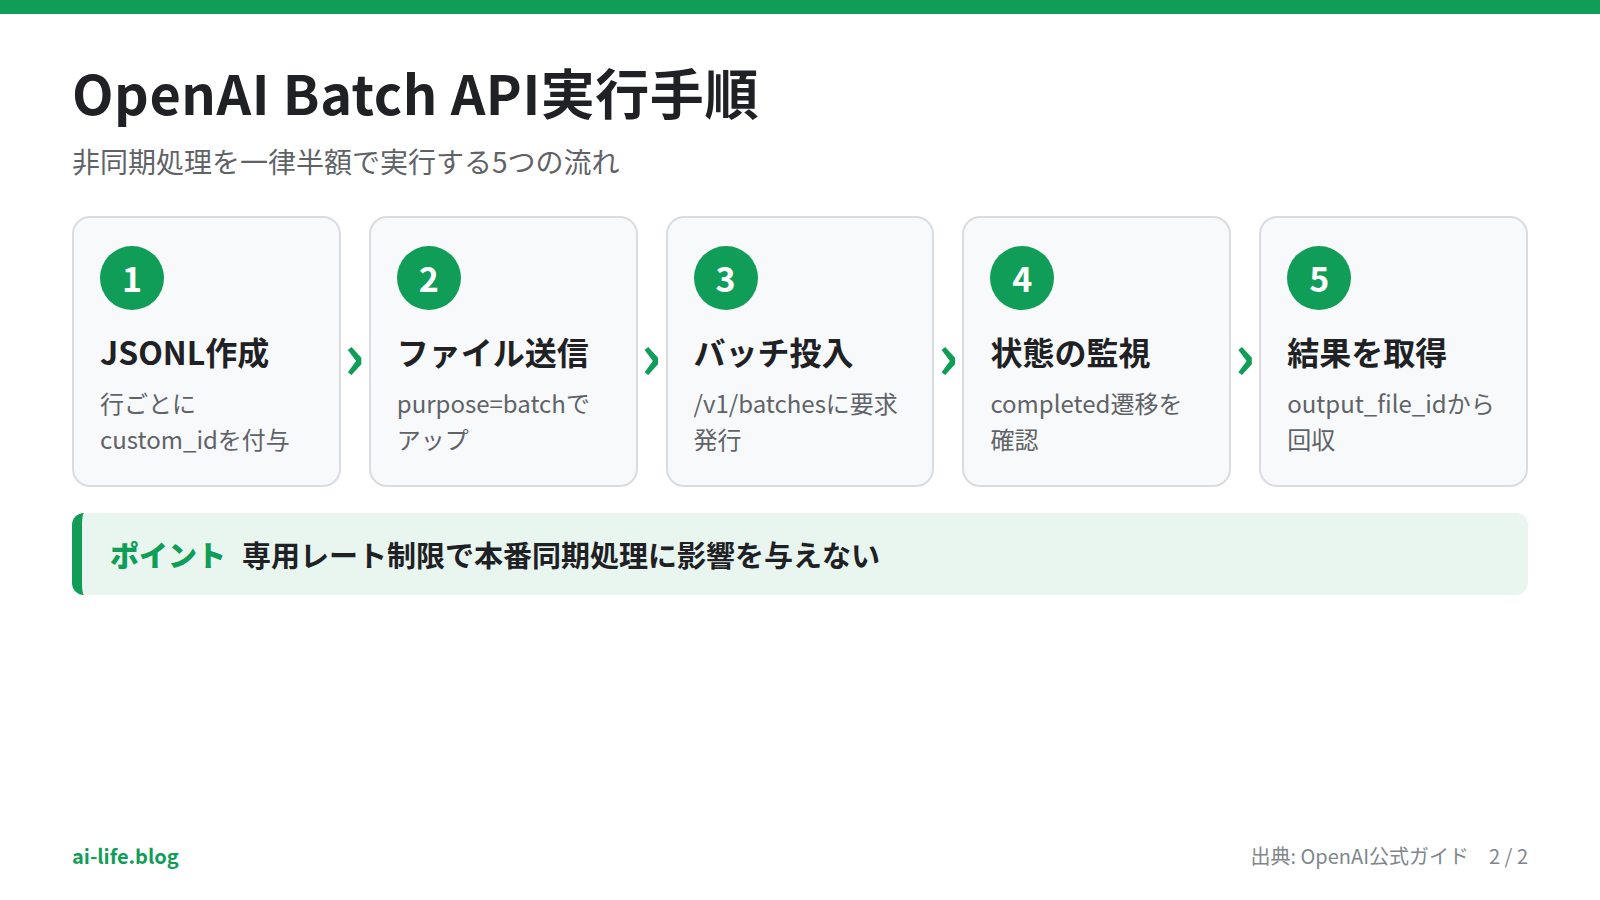
Batch APIには同期API用とは独立した専用レート制限プールが割り当てられます。本番稼働中の同期サービスに影響を与えずに、大量データを安定処理できる点が強みです。
対象エンドポイントには /v1/responses や /v1/chat/completions、/v1/embeddings 等が含まれます。画像生成の /v1/images/generations/edits にも対応し、投入処理は24時間以内に完了します。
Batch APIを実行する具体的な手順は次の通りです。
- JSONLファイルの作成: 1行ごとに1件の呼出を記述したJSONLファイルを作成。結果突合用として各行に固有の
custom_idを付与します(上限サイズ200MB)。 - Files APIへのアップロード:
purpose="batch"を指定して/v1/filesへファイルをPOST送信し、返却されたファイルIDを取得。 - バッチジョブの投入: ファイルIDとエンドポイントを指定。完了期限を設定して
/v1/batchesにリクエストを発行します。 - 処理ステータスの監視: バッチIDで進行状況を確認。進捗に応じて
validating、in_progress、finalizing、completedへと遷移します。 - 結果ファイルのダウンロード: 完了ステータス後に
output_file_idからファイルを取得し、custom_idで各行の結果を照合。
詳しいAPI仕様やエラー定義はOpenAI Batch API公式ガイドに掲載されています。
Batch APIの制限と注意点は以下の通りです。
- 24時間以内の完了設計であるため、即時応答が求められる対話画面には使えません。
- 一部で発生したエラーは
error_file_idに出力されるため、個別再試行の仕組みを準備しておく必要があります。 - 処理開始後に特定リクエストだけを部分キャンセルすることはできず、バッチ全体の中止のみ対応しています。
LiteLLMとOpenAI設定でAPI費用の暴走を防ぐ管理術
個別のAPI利用を割り引くだけでなく、組織全体での予期せぬ過剰請求を防ぐガバナンスが欠かせません。複数モデルを統合管理するオープンソースの「LiteLLM Proxy」と、OpenAI公式ベストプラクティスを組み合わせることで強固に防御できます。
LiteLLM Proxyには、主要なLLMプロバイダーの支出を一元追跡する機能が備わっています。2026年10月20日リリースのv1.106.1では、DockerイメージへのCosign署名検証に対応しました。さらにGemini 3.8 Flashのトークン算出適合など、本番環境向けの安全性が強化されています。(関連記事:Agents APIでのOpus 5.5とGemini 3.8性能比較)
支出統制の重要ポイントは以下の通りです。
- 4階層での支出追跡: キー(
/spend/keys)やユーザー、チーム、全社集計の4階層でコストをリアルタイムに把握可能。 - メタデータタグによる費用按分:
extra_body.metadata.tagsにタスク名を渡すことで、プロジェクト別の原価計算が自動化されます。 - ハード予算制限による自動遮断: キーやチームごとに上限額を設定します。超過時は呼出をブロックし、無限ループによる課金爆発を防止。
- OpenAI公式の月次ハード支出上限: プラットフォーム側でHard Spend Limitを設定し、予算到達時に通信を強制遮断します。
- zstd圧縮による転送効率化:
POST /v1/responsesでは zstd 圧縮(上限128MiB)に対応し、ネットワーク帯域を削減可能。 - 不要トークン生成の抑制:
max_tokensの厳格指定やstopシーケンス設定により、無駄な出力の発生を抑制。
LiteLLMの支出管理はLiteLLM Spend Trackingに記載されています。OpenAIの運用指針についてはProduction best practicesを参照してください。
導入時の注意点は以下の通りです。
- プロキシサーバー自体の維持管理が必要になるため、小規模な個人利用では運用負荷が割に合わない場合があります。
- 予算上限で通信が遮断された際、アプリ側でフォールバック処理を行わないと利用者にエラー画面が表示されます。
編集部の見解
LLMのAPIコスト対策で大切なのは、すべての処理を一律に節約しようとせず、ワークロードの性質に合わせて切り分ける姿勢です。即時応答が必須の対話や検索拡張生成(RAG)にはClaudeのプロンプトキャッシングが適しています。夜間の一括分析にはOpenAIのBatch APIを適用することで、推論品質を維持しながら支出を半減以下へ圧縮できます。
一方で、割引策をいくら導入しても、開発時のループ事故で多額の請求が発生しては意味がありません。LiteLLMやOpenAI公式のハード支出上限をあらかじめ設定し、事故を防ぐガードレールを最初に設けることが実務上の最重要課題です。大規模組織ならプロキシでの統制、個人や小規模チームなら管理画面での上限設定とキャッシュ指定から始めるのが堅実な選択肢となります。
よくある質問
Q: プロンプトキャッシングの有効期限(TTL)はどのようにカウントされますか?
A: 初回呼出でキャッシュが保存された時点から起算。標準の5分TTLでは、期限内に同じキャッシュを使うリクエストが届くたびに、有効期限がさらに5分間延長されます。
Q: Batch APIに投入した処理は24時間経過しないと結果を取得できませんか?
A: 24時間は最大完了保証時間であり、多くの処理は数分から数時間で完了します。ステータスが completed になった段階で、すぐに出力ファイルを回収可能。
Q: プロンプトキャッシングの利用に追加の申請や契約は必要ですか?
A: 事前申請や特別契約は不要です。対応モデルをAPIから呼び出す際にキャッシュ制御パラメータを渡すだけで、即座に割引が適用されます。
Q: LiteLLMの予算上限に達した際、リクエストはどう処理されますか?
A: 上限を超過したキーからのリクエストは、上流のAIプロバイダーへ送信されずプロキシ側で遮断。呼出元には予算超過エラーが即時返送されます。
まとめ
LLM APIのコスト最適化は、公式に用意された機能を組み合わせて適用することで確実に達成できます。要点は以下の3点です。
- 対話やRAGでのClaudeプロンプトキャッシング活用による入力料金90%削減
- 即時応答が不要な一括処理をOpenAI Batch APIへ回すことによる一律50%割引
- LiteLLMやOpenAI公式のハード予算制限による課金事故のシステム的遮断
まずは現在動かしているAIシステムの通信ログを点検し、夜間バッチや共通の長文指示がないか洗い出すことから始めてみてください。

コメント